
67 篇把分页做出来了,但页面顶部的搜索栏还没人管:用户填了"姓名=张、性别=男、入职时间 2007-09-01 到 2022-09-01",接口得照着这些条件去查。这一篇(PPT 第 54-65 页)要解决的就是"条件 + 分页"这两件事怎么合到一起。
PPT 把这一节拆成了四段,本篇也按这个顺序走:
| PPT 页 | 讲什么 |
|---|---|
| 54-58 | 条件分页查询的分析与基本实现(控制层收条件、SQL 写进 XML) |
| 59-61 | 优化一:请求参数太多 → 封装成一个对象接收 |
| 62-63 | 优化二:条件写死了 → 改成动态 SQL |
| 64 | 必答问答(动态 SQL 的使用场景、<if> 与 <where> 的作用) |
条件分页查询-分析(PPT 第 54-56 页)
PPT 第 54 页是本节的目录页(准备工作 / 分页查询 / 条件分页查询),第 55 页写着一句"已实现"——已实现的是分页(67 篇),本节要补的是条件。
第 56 页把三层职责重新梳了一遍,和 67 篇的原始方式对比,多了"条件"两个字:
| 层 | 职责(PPT 原文) |
|---|---|
| Controller | 接收参数(分页、条件);调用 Service 进行分页查询、获取 PageResult;响应结果 |
| Service | 使用 PageHelper 完成分页条件查询;封装 PageResult 对象并返回 |
| Mapper | SQL:select ... from emp e ... where e.name like ? and e.gender = ? and e.entry_date between ? and ? order by ... |
请求样例也变长了,条件参数挂在分页参数前面:
/emps?name=张&gender=1&begin=2007-09-01&end=2022-09-01这四个参数正好对应页面上搜索栏的三样东西:姓名(文本框)、性别(下拉框)、入职时间(开始日期 + 结束日期)。接口文档 2.1 里那四个"否"(name/gender/begin/end)就是它们——都不是必须的,这一点很关键,下面"优化二"会看到它带来的麻烦。
控制层:接收条件参数(PPT 第 57 页)
PPT 第 57 页给了控制层的代码:
@GetMapping
public Result page(@RequestParam(defaultValue = "1") Integer page,
                   @RequestParam(defaultValue = "10") Integer pageSize,
                   String name, Integer gender,
                   @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate begin,
                   @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate end){
    log.info("分页查询,参数:{},{},{},{},{},{}", page, pageSize, name, gender, begin, end);
    PageResult<Emp> pageResult = empService.page(page, pageSize, name, gender, begin, end);
    return Result.success(pageResult);
}
六个参数分成两组:
- 分页参数:
page、pageSize,还是老样子用@RequestParam(defaultValue = …)给默认值; - 条件参数:
name(字符串)、gender(整数)、begin/end(入职日期范围)。
前两个条件参数没有加任何注解——33 篇讲过,简单类型参数只要形参名和 queryString 里的参数名一致就能自动接收(?name=张 对 String name)。
麻烦的是两个日期参数。PPT 在这一页下面专门提了一句:
日期时间类型参数接收时,需要通过
@DateTimeFormat注解指定前端传递的日期格式。
原因是 begin/end 的类型是 LocalDate(Java 的日期类型),而前端在 URL 上传来的是字符串 2007-09-01。Spring 默认不知道该按哪种格式把这个字符串转成 LocalDate,所以要靠 @DateTimeFormat(pattern = "yyyy-MM-dd") 明确告诉它:"按 yyyy-MM-dd 这个格式解析"。
WARNING
格式必须和前端发过来的对得上。注解里写 yyyy-MM-dd,前端就得传 2007-09-01 这种形式;如果前端传的是 2007/09/01 或 2007年09月01日,字符串解析不了,请求会直接失败(参数类型转换异常)。接口文档里 begin/end 的示例值写的就是 2010-01-01,所以后端按 yyyy-MM-dd 收——联调时日期参数报错,第一件事就是核对前后端的日期格式。
数据访问层:SQL 搬进 XML(PPT 第 57 页)
条件参数一多,SQL 也跟着变长了。PPT 第 57 页的数据访问层分成两个文件:
// EmpMapper.java:只声明方法,不写 SQL
public List<Emp> list(String name, Integer gender, LocalDate begin, LocalDate end);<!-- EmpMapper.xml:写 SQL -->
<select id="list" resultType="com.itheima.pojo.Emp">
select e.*, d.name as deptName from emp e left join dept d on e.dept_id = d.id
where e.name like concat('%',#{name},'%') and e.gender = #{gender} and e.entry_date between #{begin} and #{end}
</select>这就是 55 篇学的 XML 映射配置,三条默认规则照旧要守(文件与接口同包同名:接口在 src/main/java/com/itheima/mapper/EmpMapper.java,XML 放在 src/main/resources/com/itheima/mapper/EmpMapper.xml;namespace 是接口全限定名;语句 id 是方法名、resultType 写单条记录的类型)。
NOTE
为什么这里用 XML 而不是 @Select 注解? 55 篇给过判断标准:简单 SQL 用注解就够,复杂 SQL(长、要拼接、要动态变化)用 XML。这条 SQL 又长又要连表,而且下一步还要改成"条件可变"的动态 SQL——在注解里用字符串拼 SQL 简直是灾难,所以它必须进 XML。
两处写法说明:
#{}里写的是接口方法的形参名(name、gender、begin、end)。方法有多个参数时,#{}就按形参名取值——这是 50 篇讲的预编译占位符,能防 SQL 注入;like的写法是concat('%',#{name},'%'):把百分号拼在参数两侧,实现"包含"匹配(用户输入"张",就能匹配到"张无忌")。
必答问答(PPT 第 58 页)
| PPT 的问题 | 答案 |
|---|---|
@RequestParam 注解的使用场景? | ① 接收请求参数,参数名不一致时(形参名和 queryString 的 key 不同,用 @RequestParam("前端参数名") 对上);② 设置请求参数的默认值(@RequestParam(defaultValue = "1")——分页的 page/pageSize 就靠它) |
@DateTimeFormat 的使用场景? | 用于接收日期时间类型的参数,指定日期格式——写法 @DateTimeFormat(pattern = "yyyy-MM-dd"),配合 LocalDate 使用;不写它,2007-09-01 这样的字符串转不成日期对象 |
优化一:请求参数封装成对象(PPT 第 59-61 页)
第 59 页接着往下推:接口已经要收 6 个参数了,PPT 把请求参数和那段控制层代码又摆了一遍,问的其实是同一个问题——方法签名太长了。
问题:参数还会继续加(PPT 第 59-60 页)
PPT 第 60 页把理由说得很清楚:
如果 controller 方法的参数较多,且未来可能继续增加,这会使得方法签名变得复杂难以维护,此时可以考虑将多个请求参数封装为一个对象。
想一想也是:员工列表要 6 个参数,以后按"职位""薪资范围"查还要再加;参数一个个排在方法签名上,方法头比方法体还长,调 Service 时还要一个个按顺序传——顺序传错一个就是隐藏的 bug。
方案:EmpQueryParam(PPT 第 60 页)
PPT 第 60 页给的方案是一个专门装"查询参数"的类:
@Data
public class EmpQueryParam {
    private Integer page = 1; // 当前页码
    private Integer pageSize = 10; // 每页记录数
    private String name; // 员工姓名
    private Integer gender; // 员工性别
    @DateTimeFormat(pattern = "yyyy-MM-dd")
    private LocalDate begin; // 入职日期
    @DateTimeFormat(pattern = "yyyy-MM-dd")
    private LocalDate end; // 入职日期
}
控制层随之简化成"一个参数":
@GetMapping
public Result page(EmpQueryParam empQueryParam){
    log.info("分页查询,参数:{}", empQueryParam);
    PageResult<Emp> pageResult = empService.page(empQueryParam);
    return Result.success(pageResult);
}
对照改造前的版本,有三处变化值得注意:
- 参数变成一个对象:
page(EmpQueryParam empQueryParam)——以后加条件只在类里加字段,方法签名不动; - 默认值搬家了:
page/pageSize的默认值从@RequestParam(defaultValue = …)挪到了字段的初始值(private Integer page = 1;)——对象接收时没有defaultValue可用,就在字段上直接给默认值,效果一样(不传就是 1 和 10); @DateTimeFormat也搬家了:日期格式注解挪到字段上,照样生效。
为什么 Spring 能把 URL 上的参数装进这个对象? 因为 EmpQueryParam 是一个普通的 POJO,里面的属性名(page、pageSize、name、gender、begin、end)和 queryString 的 key 一一对应,Spring MVC 会自动按名字把参数值塞进对应的属性里——33 篇讲的"POJO 参数"就是这种用法。
Service 那边的签名也跟着简化(page(EmpQueryParam empQueryParam)),实现里把分页参数从对象里取出来:
@Override
public PageResult<Emp> page(EmpQueryParam empQueryParam) {
    //1. 设置分页参数(PageHelper)
    PageHelper.startPage(empQueryParam.getPage(), empQueryParam.getPageSize());

    //2. 执行查询
    List<Emp> empList = empMapper.list(empQueryParam);

    //3. 解析查询结果,并封装
    Page<Emp> p = (Page<Emp>) empList;
    return new PageResult<Emp>(p.getTotal(), p.getResult());
}
(数据访问层的方法也变成 List<Emp> list(EmpQueryParam empQueryParam);——SQL 里要用哪个条件,就从对象的属性里取,见下一节。)
必答问答(PPT 第 61 页)
| PPT 的问题 | 答案 |
|---|---|
queryString 查询参数的接收方式(/emps?name=xxx&gender=xxx)? | 两种:参数较少时,在 controller 方法中定义一个一个形参接收;参数较多时,在 controller 方法中定义一个对象接收(属性名与参数名对应) |
优化二:条件写死的问题(PPT 第 62-63 页)
参数接收顺了,但 SQL 里还埋着一个大问题。PPT 第 62 页把 XML 里那条 SQL 又贴了一遍,然后在旁边列出四种不同的查询需求:
select * from emp e ... where e.name like ?
select * from emp e ... where e.gender = ?
select * from emp e ... where e.name like ? and e.gender = ?
select * from emp e ... where e.gender = ? and entry_date between ? and ?它们对应页面上的真实操作:用户只填姓名、只选性别、姓名和性别都填、只选性别 + 入职时间范围……PPT 的结论只有五个字:
条件写死了
也就是说,现在 XML 里那条 SQL 的条件是固定三个(姓名 + 性别 + 日期范围):
where e.name like concat('%',#{name},'%') and e.gender = #{gender} and e.entry_date between #{begin} and #{end}只要用户有一项没填,那一项参数就是 null,而 SQL 里 e.gender = null 这种比较永远不成立(null 参与比较的结果还是 null,不是"真")——结果是一行都查不出来。要支持四种、八种、十六种条件组合,难道要写十六个查询方法?显然不行。PPT 把真正的需求写在第 62 页下面:
查询条件随着用户输入的条件变化而变化
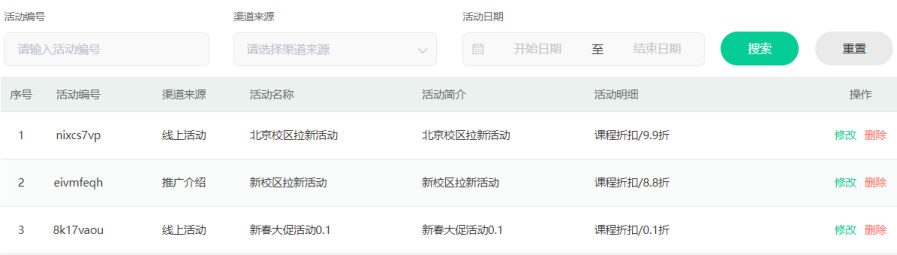 图:PPT 第 64 页配的多条件查询页面——搜索区里每个条件都可以填、也可以空着(这里画的是"活动编号 / 渠道来源 / 活动日期"三个条件),后端 SQL 必须跟着用户实际填的内容变化,这就是动态 SQL 要解决的问题
动态 SQL 是什么(PPT 第 63 页)
PPT 第 63 页给出了定义和两个标签:
随着用户的输入或外部条件的变化而变化的 SQL 语句,我们称为动态 SQL。
<if>:判断条件是否成立,如果条件为 true,则拼接 SQL。<where>:根据查询条件,来生成 where 关键字,并会自动去除条件前面多余的 and 或 or。
两个标签各管一件事,配合起来正好解决"条件个数不固定":
| 标签 | 作用 | 解决的问题 |
|---|---|---|
<if test="条件"> | 条件成立才把里面的 SQL 片段拼进去 | 用户填了哪个条件,才拼哪个条件 |
<where> | 有内容时才生成 where 关键字,并去掉开头多余的 and/or | 第一个条件前面不用纠结写不写 and;一个条件都没有时,连 where 都不生成 |
PPT 第 63 页给了一小段示例,重点是那个 test 属性:
<if test="gender != null">
    and e.gender = #{gender}
</if>
test 里写的是判断表达式(gender != null 表示"性别这个参数有值")——有值才拼 and e.gender = ?,没值就整段跳过。
改造后的完整 XML(课程最终版)
把 55 篇的三条规则和上面两个标签合起来,EmpMapper.xml 的最终写法是(课程 05. 最终代码 里就是这个):
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "https://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.itheima.mapper.EmpMapper">

    <select id="list" resultType="com.itheima.pojo.Emp">
        select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id
        <where>
            <if test="name != null and name != ''">
                e.name like concat('%',#{name},'%')
            </if>
            <if test="gender != null">
                and e.gender = #{gender}
            </if>
            <if test="begin != null and end != null">
                and e.entry_date between #{begin} and #{end}
            </if>
        </where>
        order by e.update_time desc
    </select>

</mapper>
逐条对照着看:
| 写法 | 为什么这么写 |
|---|---|
<if test="name != null and name != ''"> | 姓名是字符串,空字符串也算"没填",所以要同时判断 != null 和 != '' |
<if test="gender != null"> | 性别是数字,判断不为 null 就够 |
<if test="begin != null and end != null"> | 入职日期是范围,两个都有值才拼 between … and …(只填一个的话这个条件就不生效) |
第一个 <if> 里不写 and,后两个写 and | 无论哪个条件先被拼进来,<where> 都会把开头的 and/or 去掉——所以第一个写不写都行,课程代码选择不写 |
<where> 里一个条件都没成立 | 生成出来的 SQL 里连 where 关键字都没有,就是"查全部" |
order by e.update_time desc 放在 <where> 外面 | 排序是固定的,不属于"可变条件" |
TIP
本机实测(工程跑起来看服务端日志,同一套动态 SQL 发出两条完全不同的语句):
# 带姓名 + 性别条件(/emps?name=李&gender=1&page=1&pageSize=5)
==>  Preparing: SELECT count(0) FROM emp e LEFT JOIN dept d ON e.dept_id = d.id WHERE e.name LIKE concat('%', ?, '%') AND e.gender = ?
==>  Preparing: select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id
                 WHERE e.name like concat('%', ?, '%') and e.gender = ? order by e.update_time desc LIMIT ?

# 一个条件都不带(/emps?page=2&pageSize=5)
==>  Preparing: SELECT count(0) FROM emp e LEFT JOIN dept d ON e.dept_id = d.id
==>  Preparing: select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id
                 order by e.update_time desc LIMIT ?, ?
对比这两组日志就是动态 SQL 最有力的证据:
- 有条件时,
WHERE后面只拼了用户填的那两个条件(name like和gender =),没填的日期条件根本没出现——不是拼成了entry_date between null and null,而是整段消失; - 一个条件都不带时,SQL 里连
where关键字都没有(… d.id order by …),直接查全部——这就是<where>标签"没有条件就不生成 where"的效果,也是为什么"无条件查询"能正常返回 30 条; - 两条
LIMIT分别是LIMIT ?(第 1 页、每页 5 条)和LIMIT ?, ?(第 2 页、参数5, 5)——分页那部分还是 67 篇的 PageHelper 在管,和动态 SQL 互不干扰。
TIP
本机实测(条件分页查出来的数):GET /emps?begin=2007-09-01&end=2022-09-01&page=1&pageSize=5 返回 total 为 20、rows 5 条——只用了日期一个条件;而同一个接口不带条件时 total 是 30。同一个方法、同一段 XML,条件变了结果就跟着变,不需要写第二个查询方法。
联调时的中文坑(本机实测)
条件参数里有中文(姓名),联调时特别容易踩一个坑,顺手记在这里:
WARNING
本机实测:在 Windows 命令行里用 curl --get --data-urlencode "name=张" "http://localhost:8080/emps" 发请求,服务端日志里收到的参数是 ??、查询结果 total 是 0(查不到数据)。原因是 Windows 命令行把中文按 GBK 编码发出去,服务端按 UTF-8 解析就变成了乱码。
两个正确做法:
- 把中文先做 URL 编码再传:
?name=%E6%9D%8E(查"李")→ 正常返回total6 条; - 改用 Apifox、浏览器或前端页面发请求——这些工具会自动做 URL 编码,不会遇到这个问题。
结论:"接口查不到数据"时,先看服务端日志里收到的参数对不对,别急着怀疑 SQL。
必答问答(PPT 第 64 页)
| PPT 的问题 | 答案 |
|---|---|
| Mybatis 中动态 SQL 的使用场景? | 如果 SQL 语句是不固定的,是随着用户的输入或外部条件的变化而变化的——就比如本节的条件分页查询:用户填几个条件、填哪几个都不一定 |
MyBatis 中动态 SQL 的 <if> 及 <where> 标签的作用? | <if>:条件判断,如果条件成立,则拼接对应的 SQL 片段;<where>:根据查询条件来生成 where 关键字,并会自动去除条件前面多余的 and 或 or |
小结
| 问题 | 答案 |
|---|---|
| 条件分页查询要接哪几个条件? | name(姓名)、gender(性别)、begin/end(入职日期范围),都不必须 |
| 日期参数怎么接收? | @DateTimeFormat(pattern = "yyyy-MM-dd") + LocalDate——指定前端传来的日期格式;格式对不上会转换失败 |
| SQL 为什么写进 XML? | SQL 长、要连表、还要动态变化——55 篇的规则:复杂 SQL 用 XML;同包同名、namespace 是接口全限定名、id 是方法名 |
| 六个参数怎么接收更好? | 封装成 EmpQueryParam 对象(page/pageSize 默认值写在字段上、@DateTimeFormat 也挪到字段上);参数少用形参、参数多用对象 |
| 条件写死有什么问题? | 用户没填的条件是 null,而 字段 = null 永远不成立 → 一行都查不出来;条件组合太多也不可能穷举 |
| 什么是动态 SQL? | 随着用户的输入或外部条件的变化而变化的 SQL 语句 |
<if> 和 <where> 各干什么? | <if> 条件成立才拼接 SQL 片段;<where> 生成 where 关键字并去掉多余的 and/or(没有条件时连 where 都不生成) |
| 本机实测怎么证明动态 SQL 生效了? | 无条件时日志里的 SQL 连 where 都没有;带姓名 + 性别时只拼了这两个条件,日期条件整段消失 |
| 分页和条件会互相影响吗? | 不会——条件由 <if>/<where> 拼进原 SQL,分页由 PageHelper 自动加 LIMIT,日志里能同时看到两者 |
| 中文条件查不到数据是什么原因? | Windows 命令行下 curl 把中文按 GBK 发出去,服务端收到 ??(本机实测 total 为 0);改用 URL 编码(?name=%E6%9D%8E → total 6 条)或 Apifox/浏览器 |
相关
练习题
一、知识回顾(读完直接做下面的实践题)
- 条件分页查询的条件:
name(姓名)、gender(性别)、begin/end(入职日期范围),接口文档里四个都是"否"(可以不填) - 三层职责的变化:Controller 接收参数(分页 + 条件);Service 用 PageHelper 完成分页条件查询并封装
PageResult;Mapper 的 SQL 里带上条件 - 日期参数:
LocalDate类型 +@DateTimeFormat(pattern = "yyyy-MM-dd")——不指定格式,2007-09-01这样的字符串转不成日期;格式要和前端传的一致 - 两个注解的使用场景:
@RequestParam用于参数名不一致时指定名字、以及用defaultValue设置默认值;@DateTimeFormat用于接收日期时间类型参数并指定日期格式 - SQL 为什么进 XML:SQL 长、连表、要动态变化——用 XML(同包同名、
namespace是接口全限定名、id是方法名、resultType是单条记录类型) - 请求参数封装:参数多且会继续增加 → 封装成
EmpQueryParam(@Data);默认值写在字段上(page = 1、pageSize = 10);@DateTimeFormat也挪到字段上;queryString 参数少用形参、多用对象 - 条件写死的问题:用户没填的参数是
null,字段 = null永远不成立 → 查不出数据;条件组合太多,不可能每种都写一个方法 - 动态 SQL 定义与两个标签:动态 SQL 是随着用户的输入或外部条件的变化而变化的 SQL 语句;
<if test="…">条件成立才拼接 SQL 片段;<where>生成where关键字并去掉多余的and/or;无条件时连where都不生成(本机实测日志可证) - 本机实测的两个数:带日期条件(2007-09-01 ~ 2022-09-01)时
total是 20;不带条件时total是 30 - 中文条件的坑:Windows 命令行 curl 发中文按 GBK → 服务端收到
??、total0;URL 编码后(?name=%E6%9D%8E)正常返回total6 条
二、裸写题
- 提示(先自己想,实在想不出再点开)
一级 · 思路:六个形参排一排——两个分页参数要默认值,两个简单条件直接收,两个日期要告诉 Spring 按什么格式解析 二级 · 方法:分页参数用
@RequestParam(defaultValue = …);姓名用String、性别用Integer;日期用LocalDate+@DateTimeFormat(pattern = "yyyy-MM-dd");方法里先用log.info打印参数,再调 Service 三级 · 骨架:@GetMapping public Result page(@RequestParam(defaultValue = "1") Integer page, @RequestParam(defaultValue = "10") Integer pageSize, String name, Integer gender, @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate begin, @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate end) { log.info(…); PageResult<Emp> pageResult = empService.page(…); return Result.success(pageResult); }- 参考答案(做完再点开)
java@GetMapping public Result page(@RequestParam(defaultValue = "1") Integer page, @RequestParam(defaultValue = "10") Integer pageSize, String name, Integer gender, @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate begin, @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate end){ log.info("分页查询,参数:{},{},{},{},{},{}", page, pageSize, name, gender, begin, end); PageResult<Emp> pageResult = empService.page(page, pageSize, name, gender, begin, end); return Result.success(pageResult); }说明:
name/gender不加注解也能收(形参名和 queryString 的 key 一致);两个日期参数必须有@DateTimeFormat,否则2007-09-01转不成LocalDate,请求直接失败。日志那一行六个{}要按顺序对上实参——联调时先看它,能立刻确认"条件到底传进来没有"。- 提示(先自己想,实在想不出再点开)
一级 · 思路:建一个 POJO 装这六个参数,属性名和 queryString 的 key 一模一样;默认值从"注解"搬到"字段初始值" 二级 · 方法:类名
EmpQueryParam,标@Data;page = 1、pageSize = 10直接写字段初始值;@DateTimeFormat(pattern = "yyyy-MM-dd")标在begin/end字段上;控制层改成page(EmpQueryParam empQueryParam)三级 · 骨架:@Data public class EmpQueryParam { private Integer page = 1; private Integer pageSize = 10; private String name; private Integer gender; @DateTimeFormat(pattern = "yyyy-MM-dd") private LocalDate begin; @DateTimeFormat(pattern = "yyyy-MM-dd") private LocalDate end; }+@GetMapping public Result page(EmpQueryParam empQueryParam){ log.info("分页查询,参数:{}", empQueryParam); PageResult<Emp> pageResult = empService.page(empQueryParam); return Result.success(pageResult); }- 参考答案(做完再点开)
java@Data public class EmpQueryParam { private Integer page = 1; // 当前页码 private Integer pageSize = 10; // 每页记录数 private String name; // 员工姓名 private Integer gender; // 员工性别 @DateTimeFormat(pattern = "yyyy-MM-dd") private LocalDate begin; // 入职日期 @DateTimeFormat(pattern = "yyyy-MM-dd") private LocalDate end; // 入职日期 }java@GetMapping public Result page(EmpQueryParam empQueryParam){ log.info("分页查询,参数:{}", empQueryParam); PageResult<Emp> pageResult = empService.page(empQueryParam); return Result.success(pageResult); }说明:Spring 能自动把 URL 上的参数装进这个对象,靠的是属性名与参数名一致(
?name=张→name属性)。两处容易忘:① 默认值要写在字段上(对象接收没有defaultValue可用);②@DateTimeFormat也要跟着挪到字段上。以后加条件只在类里加字段,控制层方法一个字都不用改——这就是封装的收益。- 提示(先自己想,实在想不出再点开)
一级 · 思路:先想 SQL 本身(连表 + 三个条件 + 排序),再套 XML 的外壳(55 篇的三条规则) 二级 · 方法:文件放
src/main/resources/com/itheima/mapper/EmpMapper.xml(与接口同包同名);<mapper namespace="com.itheima.mapper.EmpMapper">;<select id="list" resultType="com.itheima.pojo.Emp">;模糊匹配用like concat('%',#{name},'%'),范围用between #{begin} and #{end},别名用d.name deptName三级 · 骨架:<?xml version="1.0" encoding="UTF-8" ?>+<!DOCTYPE mapper …>+<mapper namespace="____"> <select id="____" resultType="____"> select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id where ____ </select> </mapper>- 参考答案(做完再点开)
xml<?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "https://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.itheima.mapper.EmpMapper"> <select id="list" resultType="com.itheima.pojo.Emp"> select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id where e.name like concat('%',#{name},'%') and e.gender = #{gender} and e.entry_date between #{begin} and #{end} order by e.update_time desc </select> </mapper>说明:文件放
src/main/resources/com/itheima/mapper/EmpMapper.xml(与EmpMapper接口"同包同名");namespace是接口全限定名com.itheima.mapper.EmpMapper;语句id="list"与接口方法名一致;resultType写单条记录的类型(接口返回List<Emp>,这里还是写com.itheima.pojo.Emp)。这条 SQL 跑起来"看起来"没问题——只要三个条件都填。下一题就来看它的毛病。- 提示(先自己想,实在想不出再点开)
一级 · 思路:每个条件都用"有没有值"包起来;
where关键字和多余的and交给标签去管 二级 · 方法:每个条件外面套<if test="…">(字符串要同时判!= null和!= '';日期范围两个参数都有值才拼);外面套<where>;order by放在<where>外面 三级 · 骨架:<where> <if test="name != null and name != ''"> e.name like concat('%',#{name},'%') </if> <if test="gender != null"> and e.gender = #{gender} </if> <if test="begin != null and end != null"> and e.entry_date between #{begin} and #{end} </if> </where> order by e.update_time desc- 参考答案(做完再点开)
xml<select id="list" resultType="com.itheima.pojo.Emp"> select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id <where> <if test="name != null and name != ''"> e.name like concat('%',#{name},'%') </if> <if test="gender != null"> and e.gender = #{gender} </if> <if test="begin != null and end != null"> and e.entry_date between #{begin} and #{end} </if> </where> order by e.update_time desc </select>两个标签解决的问题:
<if>让"填了的条件才拼进 SQL"——没填的条件整段消失(不是拼成= null);<where>负责生成where关键字、并去掉第一个条件前多余的and(所以后两个条件都写and、第一个不写也能拼对),一个条件都没有时连where都不生成。本机实测的日志正是这样:带姓名 + 性别时WHERE e.name LIKE concat('%', ?, '%') AND e.gender = ?,不带条件时… d.id order by …(连where都没有),两种情况都能正常返回数据。
三、综合题
- 控制层:接收分页参数(默认 1 和 10)+ 姓名/性别/入职日期范围(日期按
yyyy-MM-dd解析); - 数据访问层:把 SQL 写进 XML(同包同名、
namespace与id按 55 篇的规则),先写条件写死的版本; - 业务层:用分页插件完成分页(67 篇的做法),把分页参数从请求对象里取出来;
- 启动工程,先用"三个条件都填"的请求验证接口能查出数据(
/emps?name=李&gender=1&begin=2007-09-01&end=2022-09-01&page=1&pageSize=5),记下total和rows的条数; - 再发一个"只填日期范围"的请求(
/emps?begin=2007-09-01&end=2022-09-01&page=1&pageSize=5),观察返回的total——为什么它和刚才不一样? 如果只填姓名、其余空着,会发生什么? - 把 XML 改成"按需拼接条件"的动态 SQL,重启后再发一个什么条件都不带的请求(
/emps?page=1&pageSize=10),把服务端日志里那条 SQL 抄下来——注意里面有没有where; - 用 Apifox(不要用 Windows 命令行的 curl 直接传中文)发一个带中文姓名的请求(比如
name=李),记录total;再回答:为什么命令行 curl 传中文会查不到数据、该怎么处理? - 最后回答三个问题:
- 为什么"条件写死"的 SQL 在用户只填部分条件时查不出数据?
<if>和<where>各解决了什么问题?- 动态 SQL 改完之后,分页还正常吗?从日志里哪里能看出来?
涉及知识点
知识点 在这里的应用 参数接收(queryString) 第 1 步——简单参数直接收、日期用 @DateTimeFormat指定格式请求参数封装 第 1、3 步—— EmpQueryParam装六个参数,默认值写在字段上XML 映射配置 第 2 步——同包同名、 namespace、id、resultTypePageHelper 分页 第 3、5、8 步—— startPage+ 解析Page,日志里看LIMIT动态 SQL( <if>/<where>)第 6、7、8 步——条件按需拼接、无条件时不生成 where联调与编码 第 7 步——中文参数的 URL 编码 - 提示(先自己想,实在想不出再点开)
一级 · 思路:先"能查出数据"(条件都填),再故意"少填条件"制造问题,然后用动态 SQL 修掉它——每一步都用日志和
total做证据 二级 · 方法:@DateTimeFormat(pattern = "yyyy-MM-dd");XML 里like concat('%',#{name},'%')/between #{begin} and #{end};动态 SQL 用<where>包<if test="…">;请求用 Apifox 或对中文做 URL 编码 三级 · 骨架:控制层page(EmpQueryParam empQueryParam)→ 业务层PageHelper.startPage(…)+empMapper.list(empQueryParam)→ XML 的<where>+ 三个<if>;对比观察点:日志里WHERE后拼了哪些条件、LIMIT的参数是几、total是 20 还是 30- 参考答案(做完再点开)
1~3. 三个文件:控制层与
EmpQueryParam见 2-1、2-2 的参考答案;XML 见 2-4 的参考答案;业务层:java@Override public PageResult<Emp> page(EmpQueryParam empQueryParam) { //1. 设置分页参数(PageHelper) PageHelper.startPage(empQueryParam.getPage(), empQueryParam.getPageSize()); //2. 执行查询 List<Emp> empList = empMapper.list(empQueryParam); //3. 解析查询结果,并封装 Page<Emp> p = (Page<Emp>) empList; return new PageResult<Emp>(p.getTotal(), p.getResult()); }4. 三个条件都填(本机实测):
/emps?name=李&gender=1&begin=2007-09-01&end=2022-09-01&page=1&pageSize=5能查出数据,日志里WHERE后面是e.name like concat('%', ?, '%') and e.gender = ? and e.entry_date between ? and ?——三个条件都在。 5. 只填日期范围(本机实测):/emps?begin=2007-09-01&end=2022-09-01&page=1&pageSize=5返回total为 20、rows5 条;它和不带条件时(total为 30)不一样,因为多了一个日期范围限制,符合条件的员工变少了。而如果条件写死、只填姓名、性别和日期空着,SQL 里的e.gender = null和e.entry_date between null and null永远不成立,结果是一行都查不出来——这就是必须改成动态 SQL 的原因。 6. 改成动态 SQL 后的无条件请求(本机实测):text==> Preparing: SELECT count(0) FROM emp e LEFT JOIN dept d ON e.dept_id = d.id ==> Preparing: select e.*, d.name deptName from emp e left join dept d on e.dept_id = d.id order by e.update_time desc LIMIT ?, ?SQL 里没有
where(… d.id order by …直接接排序)——<where>标签发现一个<if>都没成立,就没生成where关键字;这正是动态 SQL 生效的证据。 7. 中文条件:用 Apifox 发name=李能正常返回(本机实测:把中文做 URL 编码后?name=%E6%9D%8E返回total6 条);而 Windows 命令行里curl --get --data-urlencode "name=张"会把中文按 GBK 发出去,服务端日志里参数变成??、total为 0。处理办法:先把中文做 URL 编码再传,或者干脆用 Apifox / 浏览器 / 前端页面发请求(它们会自动编码)。 8. 三个问题的答案:- 条件写死时,没填的条件参数是
null,而 SQL 里字段 = null(或between null and null)永远不成立,所以整个where条件都为假,一行都查不出来。 <if>解决"条件个数不固定":填了的条件才拼进 SQL,没填的整段消失;<where>解决"where关键字和and的摆放":自动生成where、去掉多余的and/or,一个条件都没有时连where都不生成。- 分页照常工作:动态 SQL 管的是
where那一段,PageHelper 管的是在 SQL 末尾加LIMIT,两者互不干扰——日志里… order by e.update_time desc LIMIT ?, ?(第 2 页时参数是5, 5)就是证据;返回的total也仍然是"符合当前条件的总记录数"。
- 控制层:接收分页参数(默认 1 和 10)+ 姓名/性别/入职日期范围(日期按