
为什么需要流式输出
用 invoke 调用 Agent 时,内部可能经历多次模型和工具调用——用户敲完问题后,界面上长时间没有任何反应,体验很差。
流式调用(渐进式显示输出) 能实时显示 Agent 运行过程中的更新,尤其在处理 LLM 延迟时有效:
- 大模型生成完整响应通常要几秒,长输出可能 10-20 秒;用户期望即时反馈,流式让等待更可控
- 相比"干等一个完整响应",流式可以立刻看到文字逐渐出现的效果,大幅降低等待焦虑
设置方式:agent.stream(stream_mode=指定模式)。
七种输出模式
| 模式 | 输出内容 | 使用场景 |
|---|---|---|
values | 每个步骤执行后,输出完整的状态信息 | 每一步都要获取完整状态、状态持久化 |
updates(默认) | 每个步骤执行后,只增量更新状态中发生变化的内容 | 监控 Agent 执行进度(何时决定调工具、工具返回了什么) |
messages | 流式返回的 Token 及相关元数据(如来自哪个节点) | 实现类似 ChatGPT 的打字机效果 |
tasks | 当前 task 任务开始和结束的时间,含任务结果和错误信息 | 监控任务的生命周期 |
debug | 与 tasks 类似,但多输出任务步骤、时间戳、task 类型 | 调试、监控 task 生命周期 |
checkpoints | 每当检查点(checkpoint)被创建时触发,输出检查点中的状态 | 状态持久化、工作流恢复、分布式执行跟踪 |
custom | 通过 get_stream_writer 在工具或节点内部自定义发送的数据 | 输出业务进度信息("已处理 10/100 条")、自定义日志或指标 |
下面用一个"客户服务 Agent"贯穿演示(三个工具:查客户信息、查订单历史、查促销活动):
from langchain.agents import create_agent
from langchain.tools import tool
from typing import Dict, Any

@tool
def query_customer_data(customer_id: str) -> Dict[str, Any]:
    """查询客户基本信息

    Args:
        customer_id: 客户ID,用于唯一标识客户

    Returns:
        包含客户基本信息的字典,如姓名、等级、加入日期等
    """
    return {"name": "张三", "level": "VIP", "join_date": "2023-01-15"}

@tool
def check_order_history(customer_id: str) -> Dict[str, Any]:
    """查询客户订单历史

    Args:
        customer_id: 客户ID,用于唯一标识客户
    """
    return {"total_orders": 15, "total_spent": 25800.00}

@tool
def get_current_promotions() -> Dict[str, Any]:
    """获取当前可用促销活动"""
    return {"promotions": ["老用户优惠", "会员专属折扣"], "valid_until": "2027-01-31"}

customer_service_agent = create_agent(
    model=model,
    tools=[query_customer_data, check_order_history, get_current_promotions],
)

QUESTION = {"messages": [{"role": "user", "content": "查询客户id为cust1234的完整的信息、历史订单和可用优惠"}]}
values:每步的完整状态
for chunk in customer_service_agent.stream(QUESTION, stream_mode="values"):
rprint(chunk)
print("-" * 50)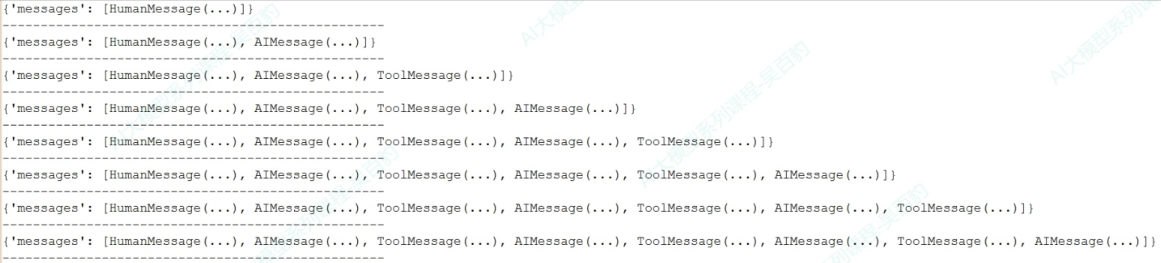 图:values 模式的输出——每一片都是"到目前为止的完整状态",消息列表一片比一片长(
[HumanMessage] → [HumanMessage, AIMessage] → … → 最后一条是最终回答)
适合每一步都要完整状态的场景(每片都是"到目前为止的全量状态",消息列表会越来越长)。
updates:只看变化(默认)
for chunk in customer_service_agent.stream(QUESTION, stream_mode="updates"):
rprint(chunk)
print("-" * 50)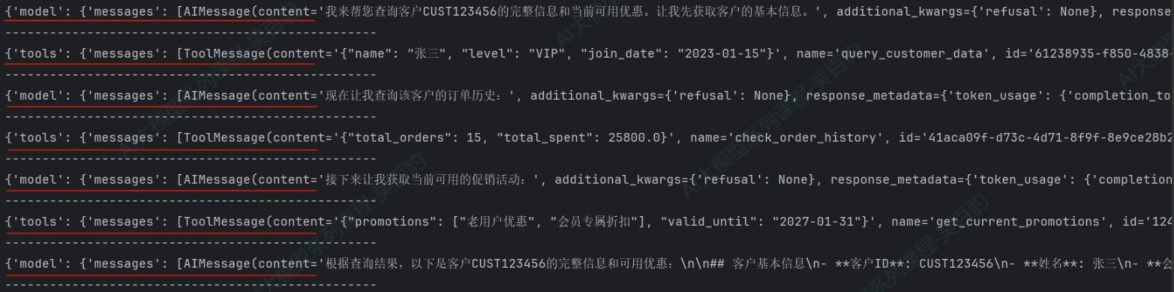 图:updates 模式的输出——每一片只带
model 或 tools 这一个节点的增量(模型决定调工具 / 工具返回了什么),比 values 清爽得多
不传 stream_mode 时就是它。每片只包含这一步新增/变化的内容——想观察"Agent 决定调用哪个工具、工具返回了什么",用这个最清爽。
messages:打字机效果
for chunk in customer_service_agent.stream(QUESTION, stream_mode="messages"):
# chunk 是元组:(消息片段, 元数据)
print(chunk[0].content, end="", flush=True)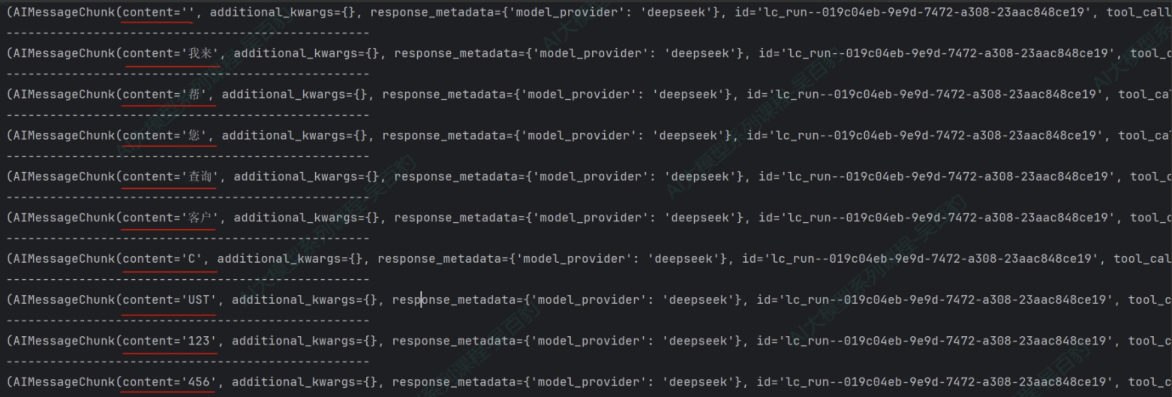 图:messages 模式的输出——一片片
AIMessageChunk,content 就是"我""来""帮""您""查""询"这样一个字一个字冒出来的 token
TIP
实测 messages 模式的 chunk 结构:它是一个二元元组。
| 位置 | 内容 |
|---|---|
chunk[0] | AIMessageChunk 对象(.content 就是这一小段文字) |
chunk[1] | 元数据字典,含 langgraph_node(来自 model 还是 tools 节点)、langgraph_step、ls_model_name 等 |
所以"打字机效果"的标准写法就是 print(chunk[0].content, end="", flush=True);想区分"这段话是模型的回答还是工具的输出",就去看 chunk[1]["langgraph_node"]。
tasks / debug:监控任务生命周期
for chunk in customer_service_agent.stream(QUESTION, stream_mode="tasks"):
rprint(chunk)
print("-" * 50)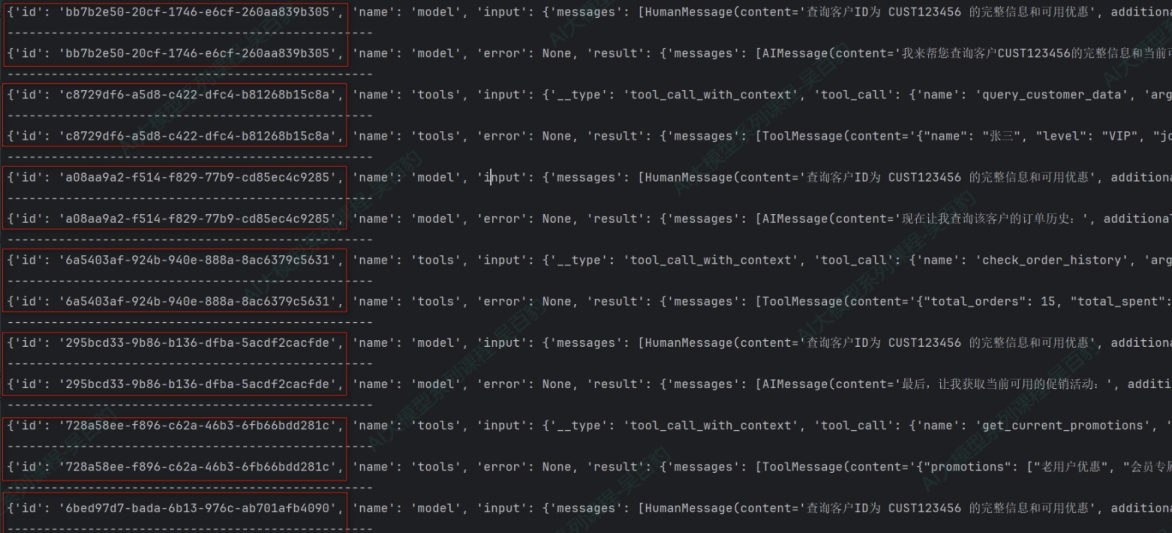 图:tasks 模式的输出——每个 task 都带
id、name(model / tools)、input、error、result,model 和 tools 交替出现,一眼看清任务生命周期
tasks 输出任务的开始/结束时间、结果与错误;debug 在它基础上多出任务步骤、时间戳、task 类型(task / task_result)。排查"Agent 卡在哪一步"时很好用。
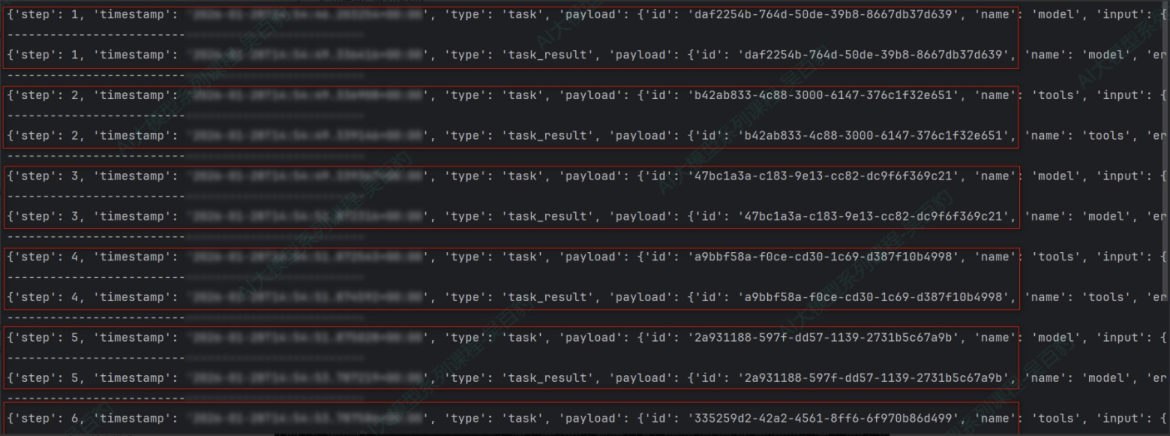 图:debug 模式的输出——比 tasks 多出
step(第几步)、timestamp、type(task 开始 / task_result 结束),而且开始和结束是成对出现的
checkpoints:需要先开检查点
from langgraph.checkpoint.memory import InMemorySaver
checkpointer = InMemorySaver()
customer_service_agent = create_agent(
model=model,
tools=[query_customer_data, check_order_history, get_current_promotions],
checkpointer=checkpointer, # ← 启用检查点
)
config = {"configurable": {"thread_id": "session01"}} # ← 唯一会话 ID
checkpoint_count = 0
for chunk in customer_service_agent.stream(
{"messages": [{"role": "user", "content": "查询客户ID为 CUST123456 的完整信息和可用优惠"}]},
config=config,
stream_mode="checkpoints",
):
checkpoint_count += 1
print(f"检查点 #{checkpoint_count}")
print(chunk)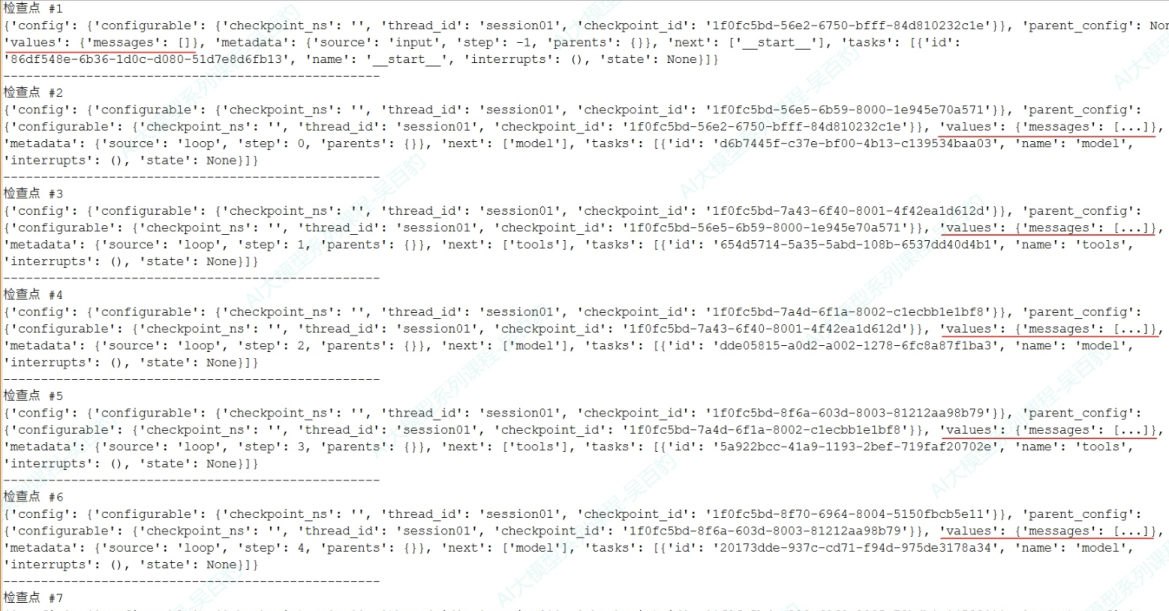 图:checkpoints 模式的输出——检查点 #1 到 #7 依次触发,每片都带
checkpoint_id、parent_config、source(input / loop)、next(下一个节点)、tasks 等状态信息
NOTE
这个模式必须配合 checkpointer(检查点存储) 使用,而且调用时要传 config={"configurable": {"thread_id": ...}}——检查点和"记忆"是第 9 章的主题,这里先知道有这么个模式即可。
NOTE
课程对这个模式还有一句关键说明:每次输出都会把相关的 MESSAGE 追加到 values.messages 中。 也就是说,每个检查点里的状态不仅有"图走到哪一步了",还有"到那一刻为止的完整对话"——所以检查点才能用来做会话恢复/记忆(第 9 章的短期记忆就是靠它落地的):从某个 checkpoint_id 把 values.messages 取回来,就能接着往下聊。
custom:在工具内部自定义进度
工具执行过程中想往外面"报进度",用 get_stream_writer:
from langgraph.config import get_stream_writer
from langchain.tools import tool
import time

@tool
def generate_sales_report() -> str:
    """生成销售报告"""
    writer = get_stream_writer()
    writer({"type": "生成销售报告", "message": "开始生成销售报告"})

    for i in range(1, 4):                      # 模拟数据处理
        time.sleep(0.5)
        writer({"type": "生成销售报告", "message": f"生成销售报告进度百分比:{i * 25}%"})

    writer({"type": "生成销售报告", "message": "报告生成完成"})
    return "销售报告:总收入150万元,同比增长12%"

reporting_agent = create_agent(model=model, tools=[generate_sales_report])

for chunk in reporting_agent.stream(
    {"messages": [{"role": "user", "content": "生成销售报告和库存报告"}]},
    stream_mode="custom",
):
    print(chunk)
工具里 writer(...) 发出去的东西,就会从这个流里冒出来——长耗时任务给用户实时进度条就靠它。
完整例子:两个工具交替上报
课程给了一个更真实的场景——同时要两份报告,于是两个工具各报各的进度,流里两条进度线交错出现:
from langchain.agents import create_agent
from langgraph.config import get_stream_writer
from langchain.tools import tool
import time

@tool
def generate_sales_report() -> str:
    """生成销售报告"""
    writer = get_stream_writer()

    writer({"type": "生成销售报告", "message": "开始生成销售报告"})

    # 模拟数据处理
    for i in range(1, 4):
        time.sleep(0.5)
        writer({"type": "生成销售报告", "message": f"生成销售报告进度百分比:{i * 25}%"})

    writer({"type": "生成销售报告", "message": "报告生成完成"})

    return f"销售报告:总收入150万元,同比增长12%"


@tool
def generate_inventory_report() -> str:
    """生成库存报告"""
    writer = get_stream_writer()
    writer("开始库存分析...")          # ← 这里直接发字符串,不一定是字典
    time.sleep(0.5)
    writer("检查当前库存量...")
    time.sleep(0.5)
    writer("生成库存报告...")

    return "当前库存量为10000件,库存充足,无异常"

# 创建报告生成 agent
reporting_agent = create_agent(model=model, tools=[generate_sales_report, generate_inventory_report])

for chunk in reporting_agent.stream(
    {"messages": [{"role": "user", "content": "生成销售报告和库存报告"}]},
    stream_mode="custom",
):
    print(chunk)
print("-" * 50)输出(片子的顺序就是真实的实时顺序):
{'type': '生成销售报告', 'message': '开始生成销售报告'}
--------------------------------------------------
开始库存分析...
--------------------------------------------------
{'type': '生成销售报告', 'message': '生成销售报告进度百分比:25%'}
--------------------------------------------------
检查当前库存量...
--------------------------------------------------
{'type': '生成销售报告', 'message': '生成销售报告进度百分比:50%'}
--------------------------------------------------
生成库存报告...
--------------------------------------------------
{'type': '生成销售报告', 'message': '生成销售报告进度百分比:75%'}
--------------------------------------------------
{'type': '生成销售报告', 'message': '报告生成完成'}
--------------------------------------------------
TIP
看这段输出有两个收获:
writer(...)的入参想发什么就发什么:字典(带type字段,方便前端按任务分组)或纯字符串都行,流里冒出来的就是原样——两种在这一份案例里都出现了。- 两条进度线是交错的:模型一次就派发了两个工具,所以销售报告的 25% 和库存报告的"检查当前库存量"交替出现。前端做进度条时按
type或内容分组,别假设"一个工具的进度会连续跑完"。
怎么选:四条经验
| 目标 | 选哪个模式 |
|---|---|
| 实现实时对话交互 | messages |
| 观察 Agent 的思考与执行步骤 | updates |
| 需要查看每一步状态 | values / tasks / debug |
| 工具执行时输出自定义业务日志 | custom |
模式还能组合:传列表即可,比如同时指定 stream_mode=["tasks", "updates"],同一个循环里既能看到任务执行内容,又能看到每一步的更新:
for stream_mode, chunk in customer_service_agent.stream(
QUESTION,
stream_mode=["tasks", "updates"],
):
print(f"当前流模式: {stream_mode}, 当前数据: {chunk}")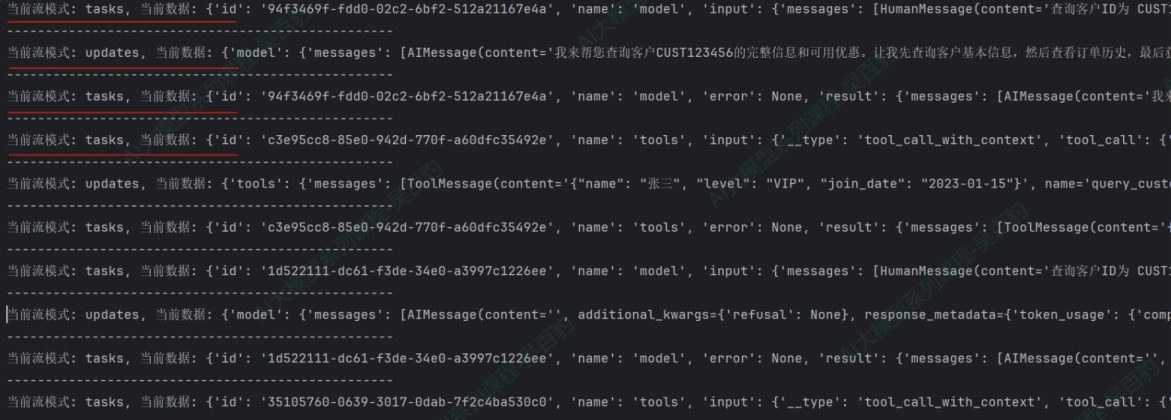 图:同时指定
["tasks", "updates"] 时的输出——每一片前面都会标出"当前流模式: tasks"或"当前流模式: updates",两类信息交错出现
TIP
组合模式下每片多了一个"模式名":for stream_mode, chunk in ... 就能知道这一片是哪来的(单个模式时不需要这样解包)。
相关
练习题
一、知识回顾(读完直接做下面的实践题)
invoke的痛点是:Agent 内部可能经历多次模型和工具调用,用户敲完问题后界面上长时间没有任何反应(干等);流式调用(agent.stream(stream_mode=...))能实时显示运行过程中的更新——大模型完整响应通常要几秒、长输出可能10-20 秒,流式能降低等待焦虑values模式每个步骤执行后输出完整状态(全量状态)(消息列表一片比一片长),适合"每一步都要完整状态"或状态持久化的场景updates是默认模式(不传stream_mode时就是它),每个步骤只输出**增量(新增或变化)**的内容——想看"Agent 决定调用哪个工具、工具返回了什么",用它最清爽messages模式流式返回Token及相关元数据,用来实现打字机效果;它的 chunk 是二元元组——chunk[0]是AIMessageChunk对象(.content就是这一小段文字),chunk[1]是元数据字典,其中langgraph_node告诉你这段来自 model 还是 tools 节点,另外还有langgraph_step、ls_model_name等tasks模式每个 task 带id、name(model / tools)、input、error、result,输出任务的开始和结束时间、结果与错误;debug模式在它基础上多输出任务的步骤(step)、时间戳、task 类型(task/task_result,成对出现)checkpoints模式必须配合checkpointer(检查点存储)使用,调用时还要传config={"configurable": {"thread_id": ...}};课程对它的关键说明是"每次输出都会把相关的消息追加到values.messages里",所以检查点里带着"到那一刻为止的完整对话",可以用来做会话恢复(记忆)custom模式:在工具或节点内部用get_stream_writer拿到 writer,把自定义数据发到流里;writer(...)的入参想发什么就发什么(随意)(字典带一个任务类型字段方便前端分组,纯字符串也行)- 两个工具被"一次派发"时,两条进度线是交错(交替)的——前端做进度条应该按任务类型字段或内容分组,别假设"一个工具的进度会连续跑完"
- 四条选型经验:实现实时对话交互选
messages;观察 Agent 的思考与执行步骤选updates;需要查看每一步状态选values/tasks/debug;工具执行时输出自定义业务日志选custom - 模式可以组合:传列表即可(比如
["tasks", "updates"]),此时循环要写成for stream_mode, chunk in ...——每片多了一个"模式名"
二、裸写题
- 提示(先自己想,实在想不出再点开)
一级 · 思路:updates 是"只报变化",所以每片很轻;片子的键就是节点名(
model/tools) 二级 · 方法:for chunk in agent.stream({...}, stream_mode="updates")三级 · 骨架:两个工具可能被一次派发,所以你会先看到一片model(带两个 tool_calls),再连着看到两片tools- 提示(先自己想,实在想不出再点开)
一级 · 思路:这个模式的每片是一小段 token(不是完整消息),而且是一个"二元组" 二级 · 方法:
chunk[0].content+chunk[1]["langgraph_node"](元数据里还有langgraph_step、ls_model_name) 三级 · 骨架:print(chunk[0].content, end="", flush=True)——end=""和flush=True别丢,否则看不清"渐进"效果- 提示(先自己想,实在想不出再点开)
一级 · 思路:进度是"工具自己发出去的",不是模型发的;这个模式只透出工具/节点主动发的数据 二级 · 方法:
from langgraph.config import get_stream_writer,工具里writer({"type": "生成销售报告", "message": "…"})/writer("开始库存分析...")三级 · 骨架:问一个"两份报告都要"的问题,模型会一次派发两个工具,于是两条进度线交错出现;time.sleep(0.5)才能看出"实时"- 提示(先自己想,实在想不出再点开)
一级 · 思路:这个模式必须先有检查点存储才会触发;每个检查点是一份"图走到哪一步 + 到那一刻的完整对话" 二级 · 方法:
from langgraph.checkpoint.memory import InMemorySaver+checkpointer=InMemorySaver();调用时config={"configurable": {"thread_id": "session01"}}、stream_mode="checkpoints"三级 · 骨架:每片取chunk["values"]["messages"]数条数(会看到 0 → 1 → 2 → 4 → 5 这样涨);片子里还有metadata["source"](input/loop)、next、tasks、config["configurable"]["checkpoint_id"]、parent_config
三、综合题
- 提示(先自己想,实在想不出再点开)
一级 · 思路:组合模式就是把两个模式名放进一个列表,再按"模式名"分流处理 二级 · 方法:
stream_mode=["messages", "custom"]+for mode, chunk in agent.stream(...)三级 · 骨架:mode == "custom"时把进度单独打出来(加个[进度]前缀),mode == "messages"时print(chunk[0].content, end="", flush=True);进度片可能夹在文字片中间——两条线本来就是交错的
- 参考答案(做完再点开)
import os
import time

from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.tools import tool
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.config import get_stream_writer

load_dotenv(override=True)

model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="openai",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_BASE_URL"),
)

# ---------- 2-1 / 2-2 的两个工具 ----------
@tool
def check_stock(product: str) -> str:
    """查询库存

    Args:
        product: 商品名称
    """
    return f"{product} 当前库存 120 件"

@tool
def check_price(product: str) -> str:
    """查询价格

    Args:
        product: 商品名称
    """
    return f"{product} 售价 2999 元"

agent = create_agent(model=model, tools=[check_stock, check_price])
question = {"messages": [{"role": "user", "content": "蓝牙耳机的库存和价格分别是多少?"}]}

# ---------- 2-1 updates 模式 ----------
for chunk in agent.stream(question, stream_mode="updates"):
    print(chunk)
    print("-" * 50)
# {'model': {'messages': [AIMessage(content='', tool_calls=[check_stock, check_price])]}}  ← 模型一次派发两个工具
# {'tools': {'messages': [ToolMessage(content='蓝牙耳机 当前库存 120 件', name='check_stock')]}}
# {'tools': {'messages': [ToolMessage(content='蓝牙耳机 售价 2999 元', name='check_price')]}}
# {'model': {'messages': [AIMessage(content='…最终回答…')]}}

# ---------- 2-2 messages 模式(打字机 + 来源节点)----------
for chunk in agent.stream(question, stream_mode="messages"):
    print(chunk[0].content, end="", flush=True)
    # 想看来源节点:
    # print(chunk[1].get("langgraph_node"), end=" ")
# 模型回答的 langgraph_node = 'model',工具输出的 langgraph_node = 'tools'

# ---------- 2-3 custom 模式:两个工具交替上报 ----------
@tool
def generate_sales_report() -> str:
    """生成销售报告"""
    writer = get_stream_writer()
    writer({"type": "生成销售报告", "message": "开始生成销售报告"})
    for i in range(1, 4):
        time.sleep(0.5)
        writer({"type": "生成销售报告", "message": f"生成销售报告进度百分比:{i * 25}%"})
    writer({"type": "生成销售报告", "message": "报告生成完成"})
    return "销售报告:总收入150万元,同比增长12%"

@tool
def generate_inventory_report() -> str:
    """生成库存报告"""
    writer = get_stream_writer()
    writer("开始库存分析...")            # ← 这里直接发字符串,不一定是字典
    time.sleep(0.5)
    writer("检查当前库存量...")
    time.sleep(0.5)
    writer("生成库存报告...")
    return "当前库存量为10000件,库存充足,无异常"

reporting_agent = create_agent(model=model, tools=[generate_sales_report, generate_inventory_report])
for chunk in reporting_agent.stream(
    {"messages": [{"role": "user", "content": "生成销售报告和库存报告"}]},
    stream_mode="custom",
):
    print(chunk)
    print("-" * 50)
# {'type': '生成销售报告', 'message': '开始生成销售报告'}
# 开始库存分析...                     ← 两条进度线交错(模型一次派发了两个工具)
# 检查当前库存量...
# {'type': '生成销售报告', 'message': '生成销售报告进度百分比:25%'}
# 生成库存报告...
# {'type': '生成销售报告', 'message': '生成销售报告进度百分比:50%'}
# {'type': '生成销售报告', 'message': '生成销售报告进度百分比:75%'}
# {'type': '生成销售报告', 'message': '报告生成完成'}

# ---------- 2-4 checkpoints 模式 ----------
checkpointer = InMemorySaver()
checkpoint_agent = create_agent(
    model=model,
    tools=[check_stock, check_price],
    checkpointer=checkpointer,                      # ← 启用检查点
)
config = {"configurable": {"thread_id": "session01"}}     # ← 唯一会话 ID

count = 0
for chunk in checkpoint_agent.stream(
    {"messages": [{"role": "user", "content": "蓝牙耳机的库存和价格分别是多少?"}]},
    config=config,
    stream_mode="checkpoints",
):
    count += 1
    messages = (chunk["values"] or {}).get("messages") or []
    print(f"检查点 #{count} | source={chunk['metadata'].get('source')} | 到这一刻已有 {len(messages)} 条消息")
print("一共触发", count, "次检查点")
# 检查点 #1 | source=input | 到这一刻已有 0 条消息      ← 图刚收到输入
# 检查点 #2 | source=loop  | 到这一刻已有 1 条消息      ← 模型回了工具调用
# 检查点 #3 | source=loop  | 到这一刻已有 2 条消息
# 检查点 #4 | source=loop  | 到这一刻已有 4 条消息
# 检查点 #5 | source=loop  | 到这一刻已有 5 条消息
# 检查点里带着"到那一刻为止的完整对话"——从某个 checkpoint_id 把 values.messages 取回来就能接着聊

# ---------- 3-1 组合模式:带进度的“打字机” ----------
@tool
def generate_report() -> str:
    """生成销售报表"""
    writer = get_stream_writer()
    writer({"type": "报表", "message": "开始生成报表"})
    for i in range(1, 4):
        time.sleep(0.5)
        writer({"type": "报表", "message": f"进度:{i * 25}%"})
    writer({"type": "报表", "message": "报表生成完成"})
    return "报表:本月销售额 150 万元,同比 +12%"

report_agent = create_agent(model=model, tools=[generate_report])

for stream_mode, chunk in report_agent.stream(
    {"messages": [{"role": "user", "content": "生成一份销售报表"}]},
    stream_mode=["messages", "custom"],
):
    if stream_mode == "custom":
        print(f"\n[进度] {chunk}")                    # 工具自己发的进度
    else:
        print(chunk[0].content, end="", flush=True)   # 模型输出的 token
# 组合模式下每片多了一个"模式名",据此分流:custom 是进度、messages 是文字